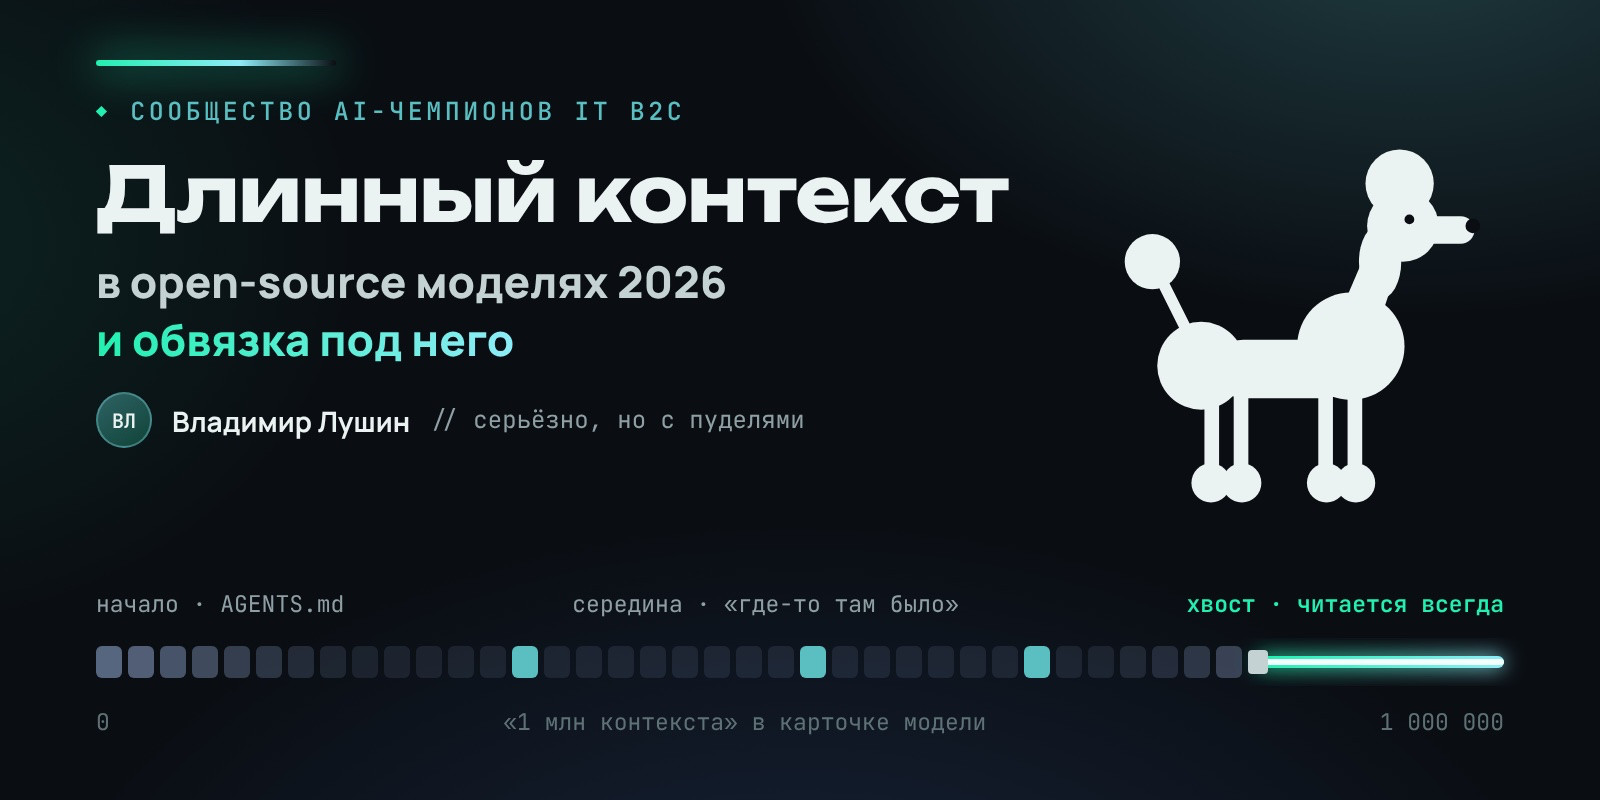
Исследование Владимира Лушина демонстрирует, что open-source модели 2026 года (включая семейства GLM-5.x, DeepSeek-V4, Qwen3.8 и Kimi K3) не используют полное внимание по всему контексту из-за вычислительных ограничений. Вместо этого они применяют разреженные методы (top-k), гибридные архитектуры или скользящие окна. В результате модель гарантированно «видит» только последние сотни токенов, а остальная информация подвергается сжатию или отбору по релевантности. Для ИИ-агентов это создает проблему «забывания» инструкций в ходе длительных сессий. Автор отмечает, что качество работы моделей часто снижается после 128–256 тыс. токенов, а методы компактизации данных могут показывать лучшие результаты, чем использование полного окна в 1 млн токенов. Для повышения надежности рекомендуется использовать чистку старого вывода инструментов, поиск по запросу, постепенное раскрытие информации и принудительный повтор правил в конце контекста.
Особенности работы с длинным контекстом в open-source моделях 2026 года
Анализ архитектур современных открытых моделей показывает, что заявленный объем контекста в 1 млн токенов не гарантирует их полное прочтение. Модели используют выборочные механизмы внимания, что требует адаптации обвязки для стабильной работы агентов.